Un assistant RAG que vous pouvez interroger tout de suite
Le cas en 30 secondes
- Problème
- Sur un portfolio, tout le monde peut affirmer qu’il livre de l’IA en production. Rien sur une page ne le prouve. Je voulais quelque chose que le visiteur puisse tester dans son navigateur, plutôt que de me croire sur parole.
- Ce que j’ai fait
- J’ai construit un pipeline de retrieval-augmented generation (RAG) sur des documents que j’ai écrits et vérifiés. Un Cloudflare Worker authentifie le visiteur puis transmet la question à un workflow n8n. Six étapes fixes s’enchaînent dans un seul sens, puis l’une des cinq issues.
- Impact
- Une réponse complète arrive en 17,2 s, pour 0 € d’infrastructure. Un seul index a multiplié la capacité par 170, et aucun lien inventé n’est arrivé jusqu’à un visiteur.
Essayez
Posez une question à Ava AI sur mon travail.
Choisissez-en une : elle part vers l’assistant, qui répond à partir des études de cas de ce site.
Deux ou trois questions suffisent pour voir comment il gère ce qu’il ignore.
Le déroulé
- Ce que c’est
Le système tourne sur la même infrastructure que le reste du site. Le corpus compte douze documents : neuf études de cas, plus mon parcours, ma méthode de travail et mon historique professionnel. J’ai écrit ou relu l’ensemble. Rien de confidentiel n’y entre, ce qui tient mieux que de demander à un modèle de se taire.
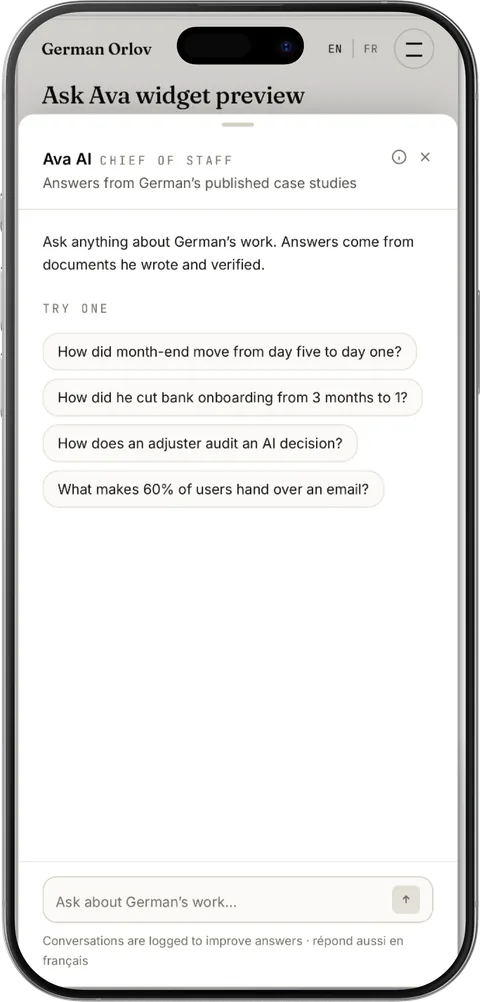
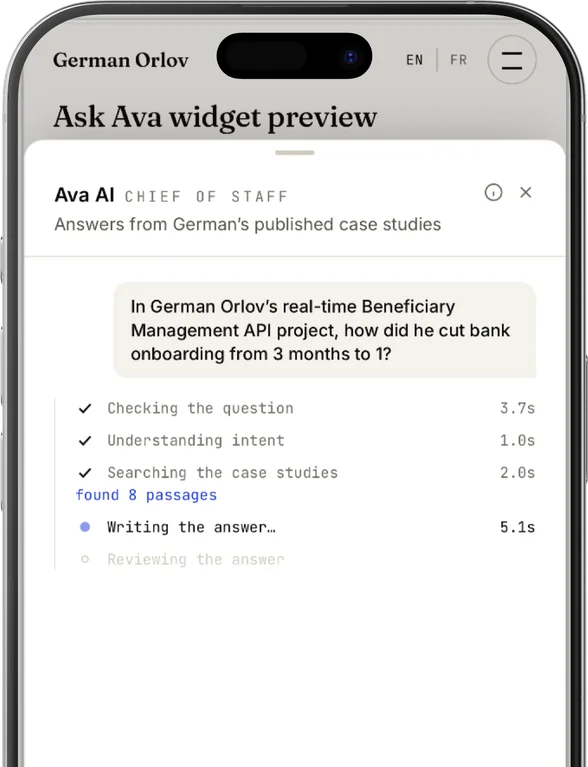
L’ensemble sur un téléphone. Les quatre questions d’ouverture sont celles que propose cette page, et elles partent vers le pipeline en production. - L’architecture
Un Cloudflare Worker authentifie le visiteur, contrôle l’entrée, puis transmet la question à un workflow n8n. Les routes sont figées : un directed acyclic graph (DAG), sans boucle, sans choix d’outil à l’exécution. Ce n’est pas agentique. Chaque question aboutit à l’une des cinq issues : une réponse, une esquive, une redirection, un refus ou une erreur.
- Six étapes, un seul chemin mesurable
- Input guardrail — la question est-elle sûre et dans le périmètre ?
- Intent classifier — que demande-t-on, dans quelle langue, et par quelle route ?
- Query transformer — reformuler la question en quelque chose qui vaille une recherche
- Retrieval — recherche vectorielle sur le corpus dans Supabase pgvector
- Answer generator — rédiger la réponse à partir des seuls passages retrouvés
- Output guardrail — relire le brouillon avant publication
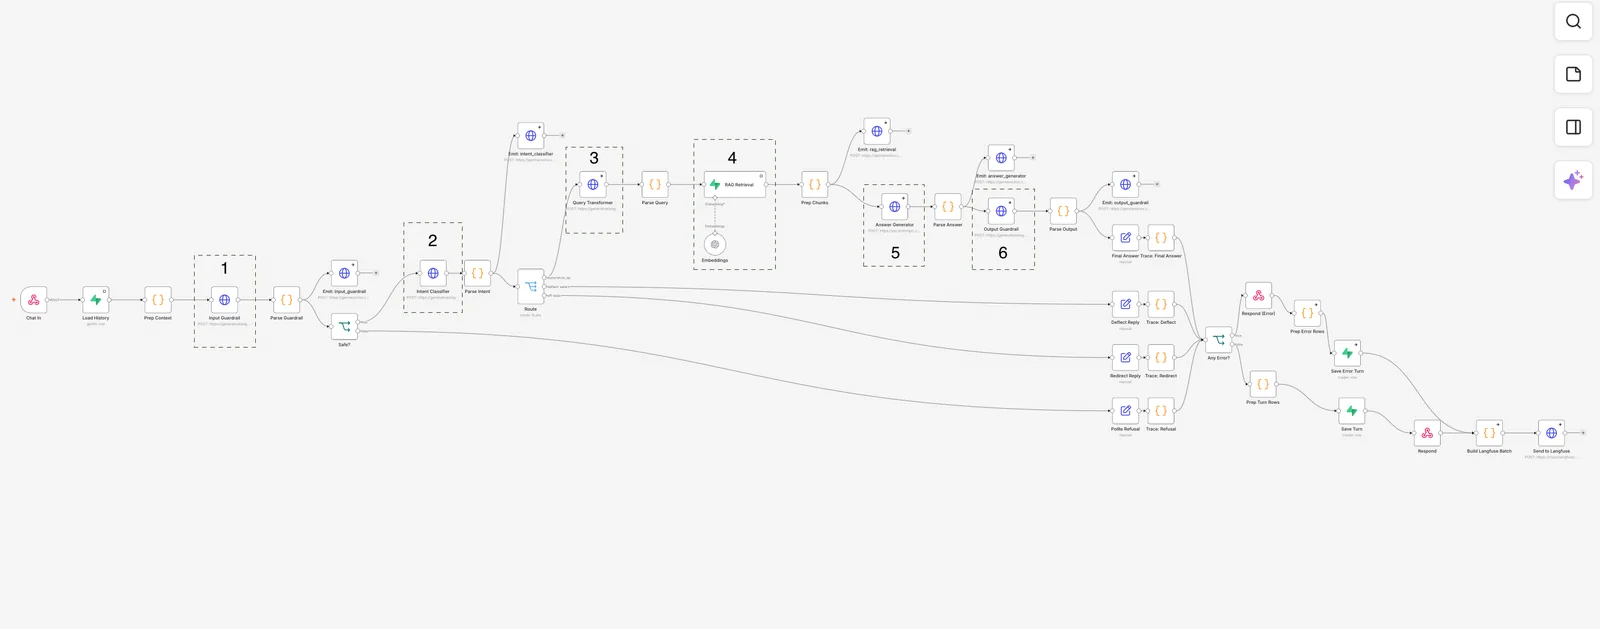
Les six étapes telles que construites. Toutes les flèches vont de gauche à droite, et les branches de sortie quittent le routeur sans jamais y revenir. - Des décisions qui méritent une explication
- Une vérification par session, pas par question
Ma première version vérifiait chaque question séparément, et elle cassait par intermittence. Les jetons de vérification sont à usage unique et expirent en quelques minutes. Que la deuxième question passe dépendait du temps passé par le visiteur à lire la première réponse. Je l’ai remplacée par une autorisation signée et limitée dans le temps, émise après un seul contrôle. Ce changement a réglé d’un coup quatre bugs que je traitais séparément.
- La progression par sondage, pas en streaming
Le pipeline émet environ six événements sur dix-sept secondes. Le streaming livrerait chacun quelques centaines de millisecondes plus tôt, ce que personne ne perçoit. Le compteur s’anime de toute façon dans le navigateur. Le sondage coûte un endpoint et ne laisse aucune connexion longue durée. Rien qui fuie, que le mobile suspende ou qu’un proxy d’entreprise mette en tampon. C’était l’option la plus ennuyeuse, et la bonne.
- Les liens sources viennent des documents retrouvés
Au début, le modèle rédigeait lui-même les titres et les liens qu’il citait. Il a fini par inventer un lien plausible qui menait à une page morte. Le modèle renvoie désormais des identifiants de documents. Le système va chercher le titre et le lien dans les documents réellement retrouvés. Un identifiant inventé ne correspond à rien et se trouve écarté. Un second contrôle valide chaque lien contre les vraies routes avant qu’il n’atteigne quiconque.
- C’est la question qui décide de la langue
Quelqu’un qui lit le site en anglais et qui écrit en français reçoit une réponse en français. La langue du site ne départage que les questions trop courtes pour être classées.
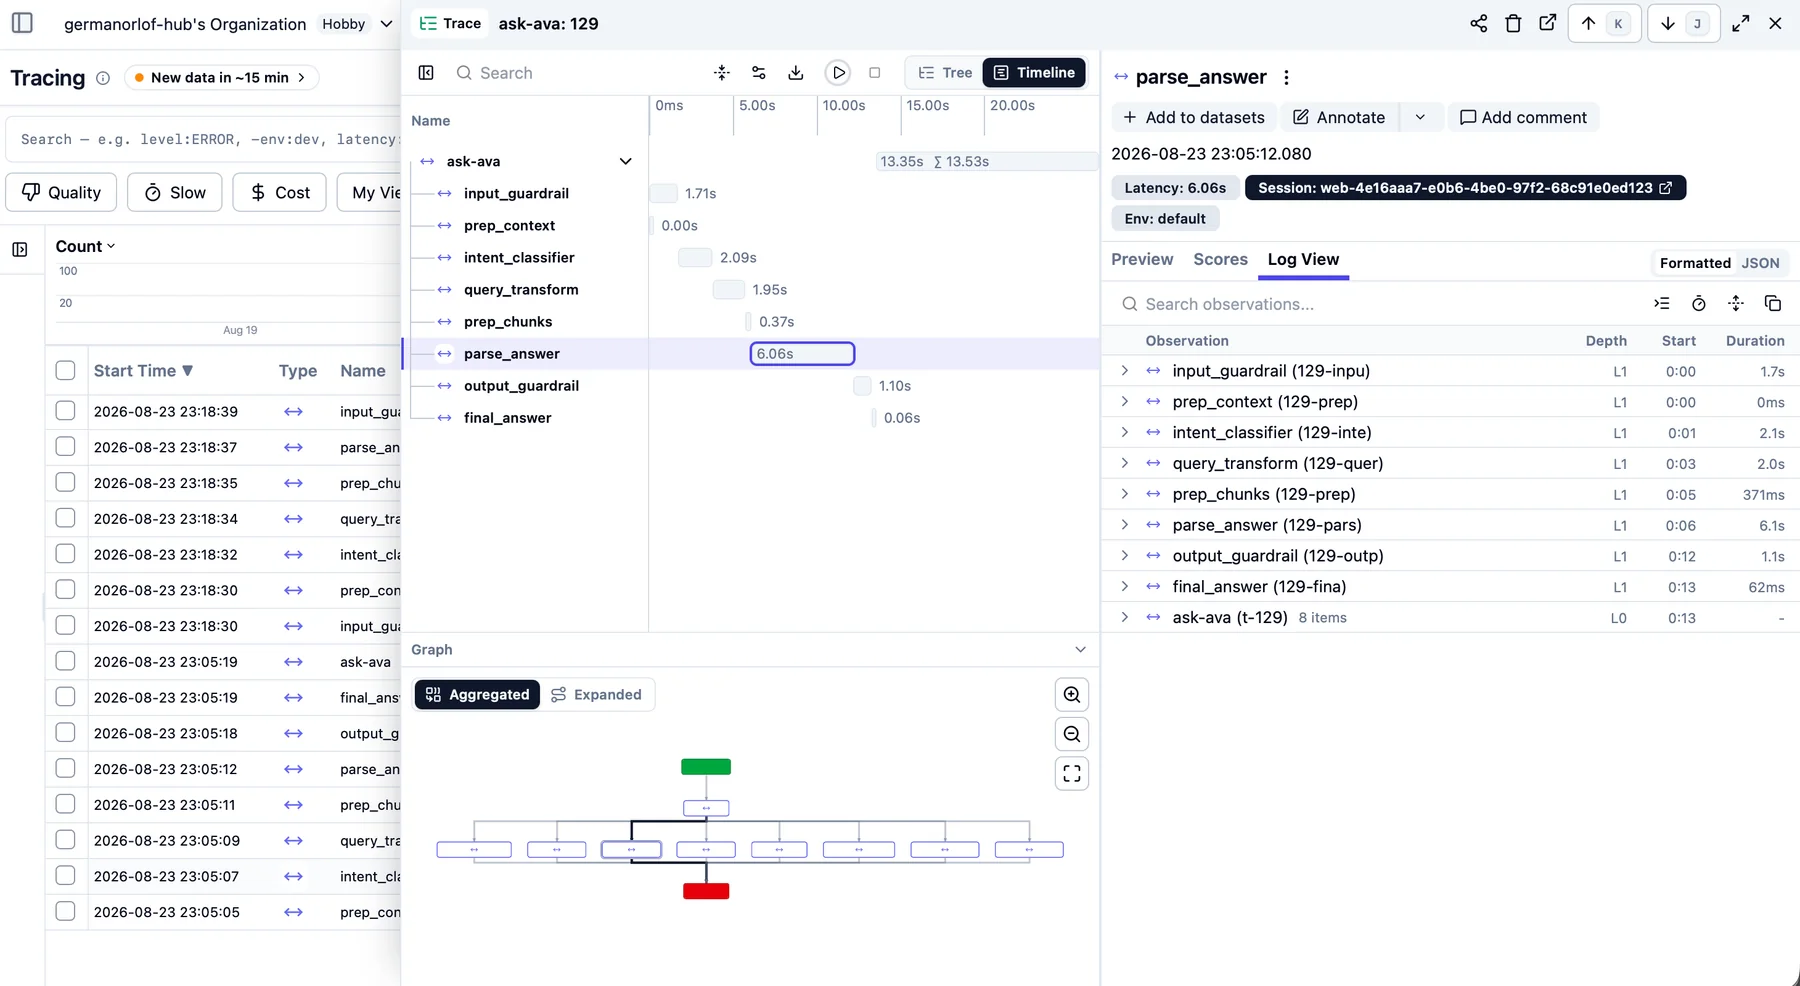
Une question de bout en bout dans Langfuse : huit spans, 13,35 s sur cette exécution, dont 6,06 s pour la rédaction de la réponse. C’est là que les pannes ci-dessous ont été trouvées. - Ce qui n’a pas marché
- Le premier indicateur de progression inventait ses chiffres
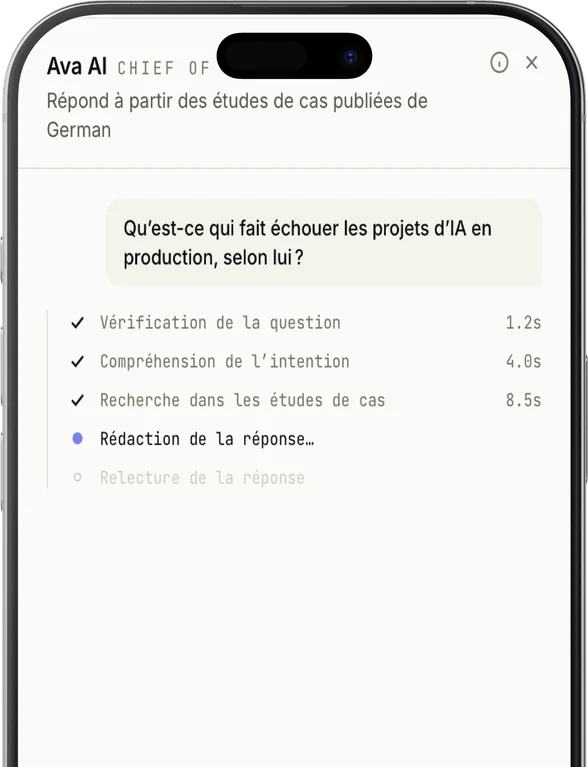
Il affichait une durée pour chaque étape. Ces durées étaient des estimations côté navigateur, identiques à chaque exécution quoi qu’il se passe réellement. C’était joli, et c’est à peu près là le problème. J’ai retiré les chiffres. Puis j’ai construit la version qui rend compte de chaque étape à mesure que le pipeline la termine, avec des durées mesurées.
- Une optimisation a discrètement affamé le modèle
Je dédoublonnais les passages retrouvés par document, en supposant qu’un document répété était redondant. C’étaient des passages différents du même article. La recherche en renvoyait cinq, quatre étaient jetés, le modèle répondait à partir d’un seul. Il s’est mis à ouvrir ses réponses en expliquant ce qu’il ne pouvait pas me dire. C’est ce que fait un modèle bien élevé quand on lui retire ses preuves. Les traces montraient cinq passages retrouvés et un seul conservé.
- La mémoire multi-tours n’avait jamais fonctionné
Les tours de conversation étaient écrits avec un jeu de noms de champs et relus avec un autre. L’historique était toujours vide. Rien ne remontait d’erreur. Les questions de suivi étaient simplement moins bonnes qu’elles n’auraient dû l’être, pendant des semaines, sans que rien ne m’alerte.
- Une clé API active en clair dans un fichier d’export
J’avais construit le nœud à partir d’un extrait de documentation. Il plaçait la clé dans un paramètre du nœud en plus du magasin de credentials. Tout fonctionnait, donc rien ne m’a fait remarquer le doublon. Puis le paramètre est sorti du magasin chiffré, à l’intérieur d’un export. J’ai fait tourner la clé le jour même. Dans cet outil, un secret vit dans le credential et nulle part ailleurs.
Avant
Après
Avant, les durées étaient des estimations côté navigateur, identiques à chaque exécution. Après, chacune est l’écart entre deux horodatages enregistrés par le pipeline. - Le schéma qui est venu en premier
Dessiné avant la moindre ligne de code : un classifier au centre, quatre routes autour, une colonne vertébrale partagée dessous. Le classifier a été conçu pour quatre routes dès le premier jour, et elles s’activent par phase. Demandez à l’assistant une route qui n’existe pas encore : il esquive au lieu d’improviser.
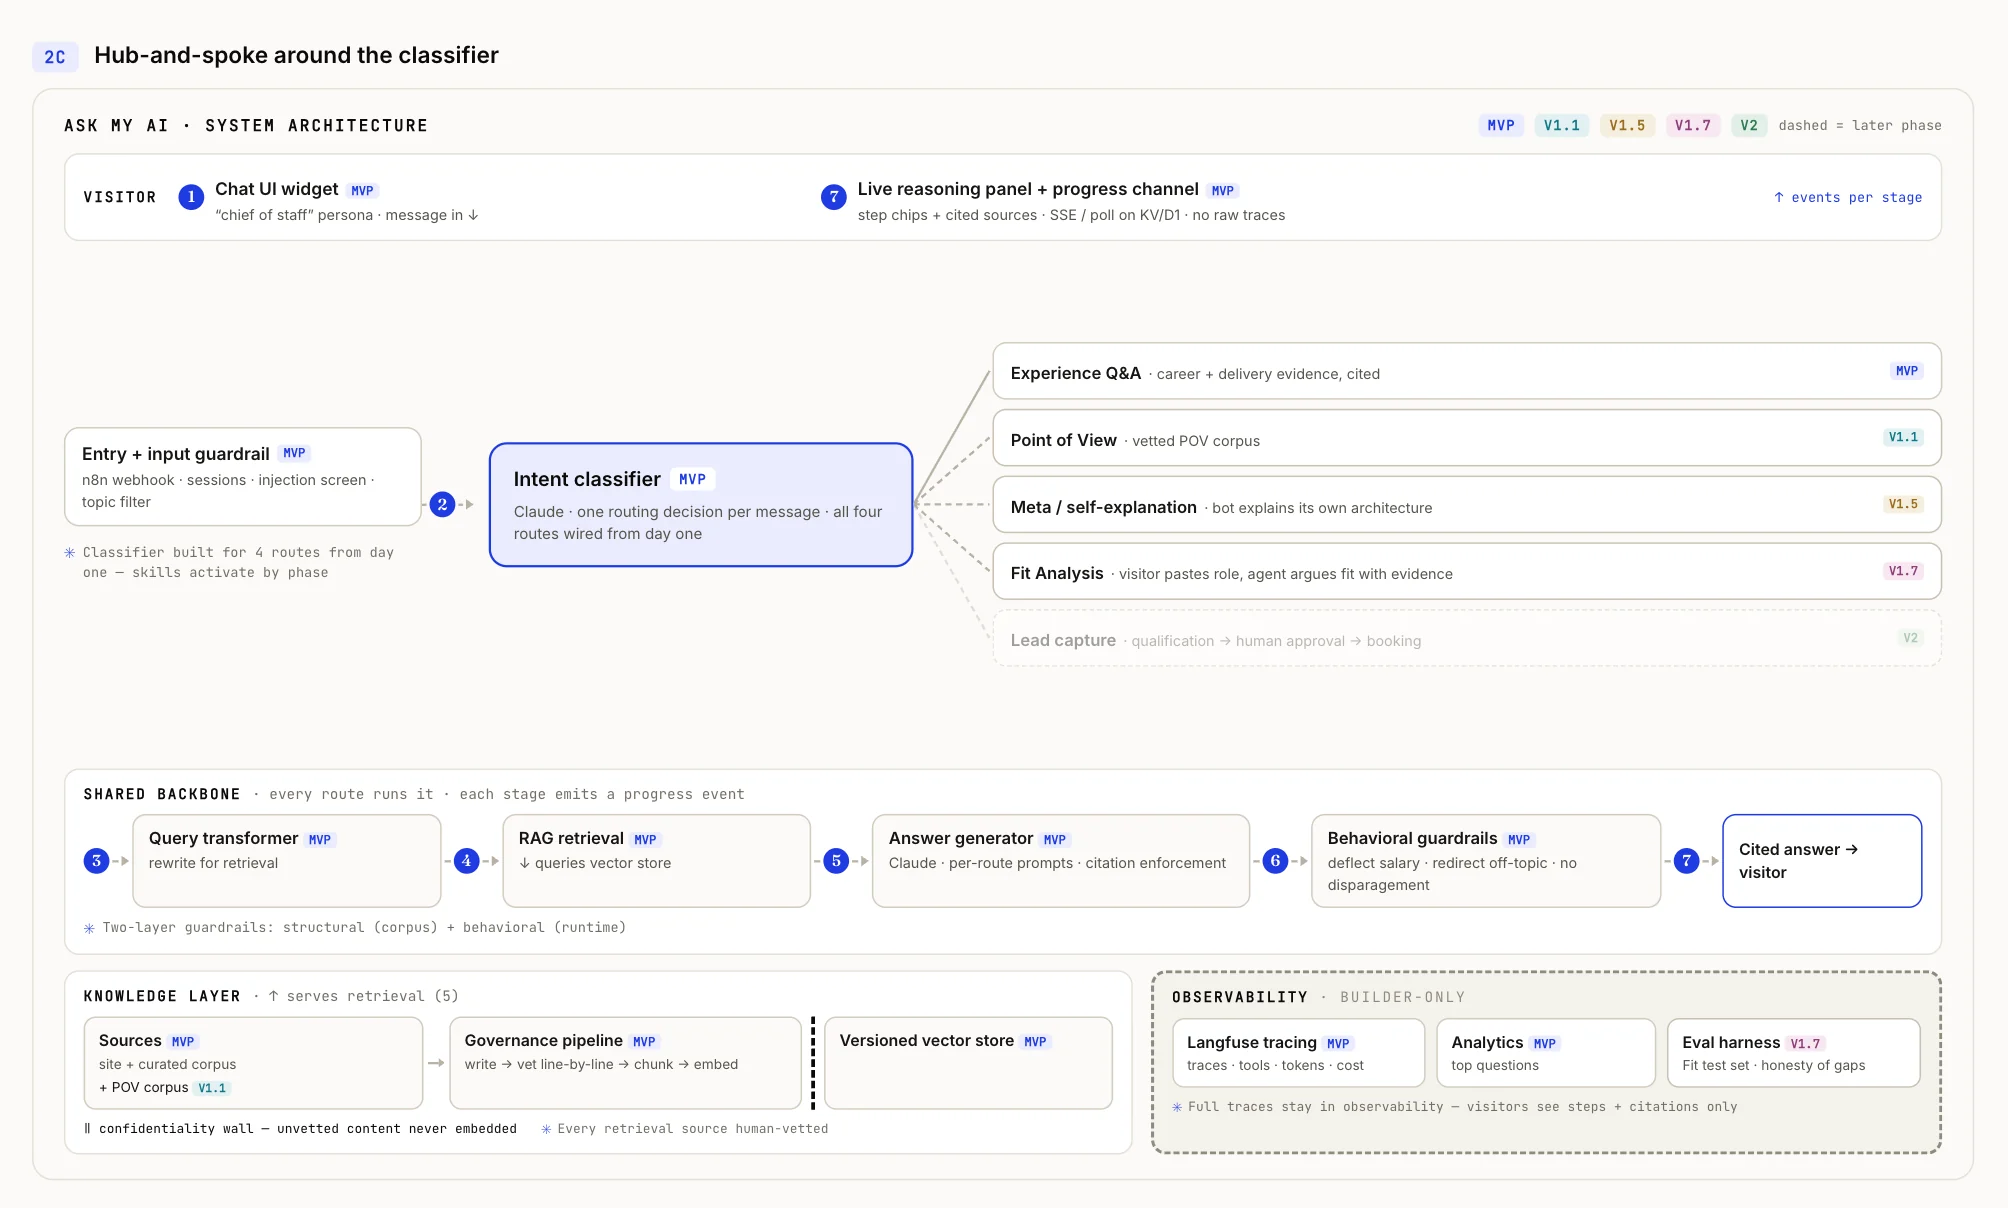
Le schéma est le plan du premier jour ; les badges de phase datent la livraison prévue de chaque bloc. Les listes ci-dessous disent ce qui tourne aujourd’hui. En ligne aujourd’hui
- Experience Q&A — la route que cette page démontre
- Fit Analysis — livrée en V1.7
- Meta, où il s’explique lui-même — livrée en V1.5
- Entry guardrail, classifier, backbone partagé, output guardrail
- Couche de connaissance et tracing Langfuse
Prévu
- Point of View et son corpus validé
- Le harnais d’évaluation
- Capture de leads
- Ce que ça coûte à faire tourner
Le site, l’API, le stockage de progression et la base vectorielle tiennent tous dans des offres gratuites. L’inférence est le seul coût réel, et elle reste sous un plafond de dépense mensuel. Un seul chiffre a déplacé la capacité de deux ordres de grandeur. Le stockage de progression facture les lignes parcourues, pas les lignes rendues.
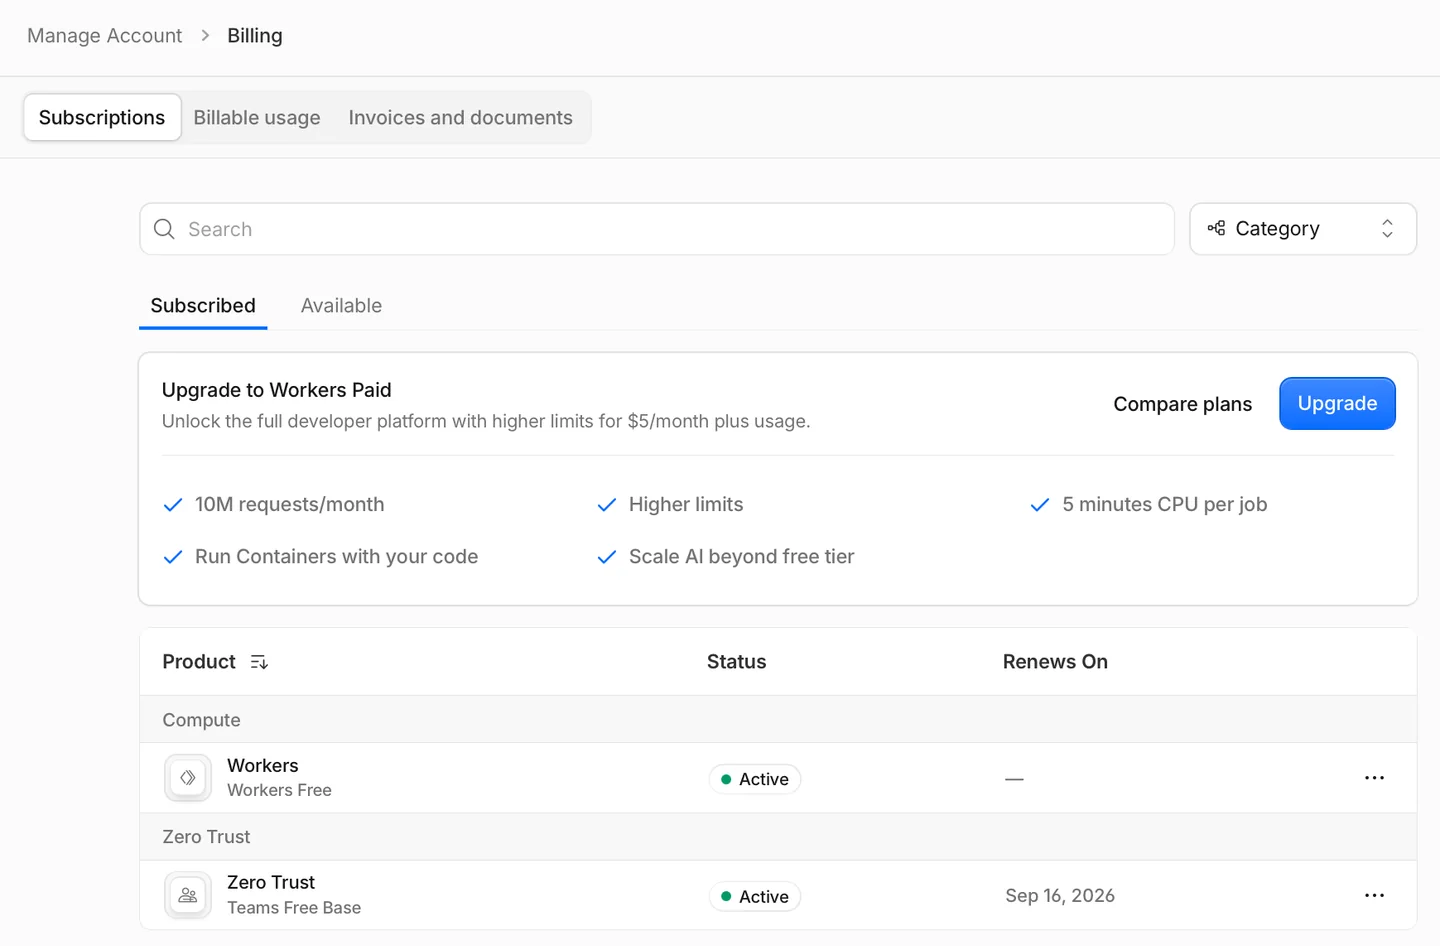
Le compte sur lequel tout tourne : deux produits souscrits, tous deux en offre gratuite, rien d’autre. La seule ligne qui coûte est l’usage des modèles, facturé ailleurs. 290questions par jour avant épuisement du quotaSans index : chaque sondage parcourait toute la table~50 000questions par jour sur le même quotaAvec l’index : un sondage lit six lignes - Ce qui changerait à l’échelle d’une entreprise
- L’évaluation doit devenir systématique
Aujourd’hui je juge les réponses en les lisant. Cela fonctionne pour une personne et cesse de fonctionner juste après. L’étape suivante est un jeu de questions de référence notées, passé comme une suite de non-régression. Il comprend des questions adverses, et d’autres auxquelles le corpus ne peut délibérément pas répondre. Un changement de prompt doit ainsi faire ses preuves.
- Le corpus a besoin d’un propriétaire
Douze documents que j’ai écrits moi-même se relisent à l’œil. Dix mille, venant d’une douzaine d’équipes, exigent une propriété, une revue et des règles de fraîcheur. Il leur faut aussi un circuit de correction. La qualité de la recherche est un problème de contenu bien avant d’être un problème de modèle.
- Quelqu’un doit surveiller les échecs
Ici, une question en échec affiche un bouton de reprise, et je le découvre quand je regarde. Dans un système en exploitation, quelqu’un doit savoir qu’elle a échoué et pourquoi. Il faut aussi savoir si cela arrive plus souvent qu’hier. Le tracing en est le socle ; l’alerting et la propriété font le reste.
- Le coût devient une donnée de conception
À cette échelle, l’offre gratuite absorbe mes erreurs. À l’échelle d’une entreprise, la profondeur de recherche, la taille du contexte et le choix du modèle portent tous un chiffre. Quelqu’un doit en répondre.
Ce que j’en retiens
Construire ça a pris quelques jours. Savoir quels angles on peut couper vient des dix années d’avant. Savoir quoi mesurer aussi, et quelles pannes restent silencieuses.